
第 1 篇給過一個請求:
{
  "model": "claude-opus-5",
  "max_tokens": 1024,
  "messages": [
    { "role": "user", "content": "我叫 Jim,請記住這件事。" }
  ]
}
那一篇說,這個結構會跟著我們走完七層,後面每加一層,都是在 messages 裡多塞一點東西,或是在外面多包一層流程。走完了,這篇把它攔下來看。
我開了一個小專案 shop-api,把前面幾層的東西各放一份進去:一份 CLAUDE.md,內容是評估集第三層附上的那種團隊筆記(第三層),一則先在另一個對話裡請 Claude Code 記下的記憶「我負責 order-api,changelog 要署名 order-api 團隊」(第四層),一個寫 changelog 格式的技能(第五層),一個只能讀檔的審查子代理(第七層)。然後只打一句話:
把最近三則 commit 整理成 changelog.md。寫完交給 changelog-reviewer 審查,照審查意見改到通過為止。
整個過程經過 token-inspectour(2026-10-13,Claude Code 2.1.296,Claude Opus 5.5,沒接 MCP,也不載入我自己使用者層的設定)。主代理送了 3 個請求,中間交辦一次審查,一次就通過,連子代理在內總共 0.12 美元。下面是最後一圈送出去的那個請求,每一塊的詞元數來自 count_tokens。分到哪一層是我分的,依據是那一塊屬於哪一層的能力,例如系統提示詞算 Claude Code 自己的第二層指令:
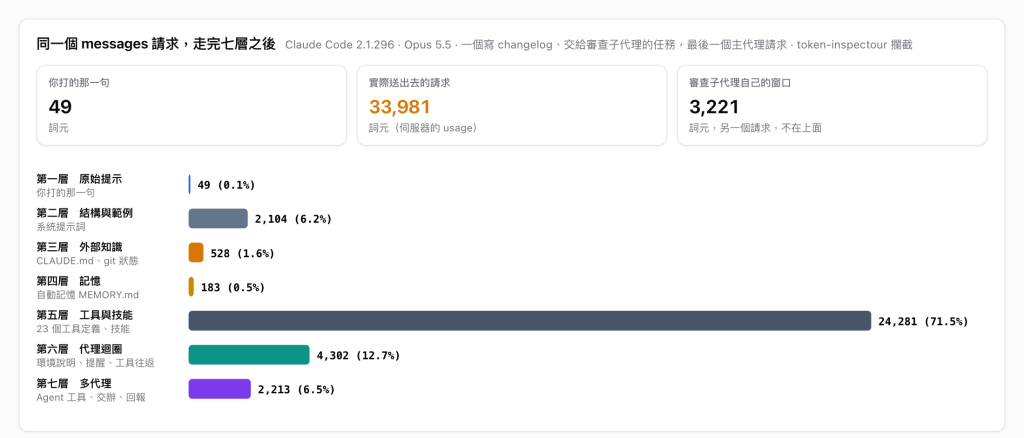
這個請求裡看得到五件事:
CLAUDE.md 和那則 183 個詞元的記憶一樣在裡面。第 28 篇講資訊在代理之間溜進來,這是一個實例。這個請求的骨架還是第 1 篇那三樣:model、max_tokens、messages,只是 max_tokens 從 1,024 變成 128,000。多出來的 system、tools,以及 thinking、stream 這類設定,都是同一個呼叫的欄位。七層加上去的東西,全部在這一個請求裡。
第 1 篇說,你今天用的每一個代理功能,本質上都是在補三個洞:
| 洞 | 補在哪一層 | 在上面那個請求裡 | 補上之後留下的問題 |
|---|---|---|---|
| 不知道你的事 | 第三層(第 5 篇到第 10 篇) | CLAUDE.md 179 詞元 |
知識庫、切塊、向量模型都會悄悄鬆掉,鬆掉時不報錯 |
| 沒有記憶 | 第四層(第 11 篇到第 15 篇) | MEMORY.md 183 詞元,加上每一圈重送的歷史 |
寫錯的記憶會跟著你進每一個新對話 |
| 不能動手 | 第五、六層(第 16 篇到第 24 篇) | 工具定義與迴圈,共約 2.9 萬詞元 | 資料和指令分不開(第 20 篇),迴圈要停得對(第 22 篇) |
三個洞都是用同一種方法補的:把東西放進窗口。所以每補一個洞,請求就長一點,帳單也跟著長。
報名時的簡介說,每一個技術節點都要問:多了什麼能力,又多付了什麼代價。七層收在一張表:
| 層 | 多了什麼能力 | 多付了什麼代價 | 篇 |
|---|---|---|---|
| 一、原始提示 | 門檻是零,打開就能用 | 三個洞都在,它可能編一個答案給你 | 1 |
| 二、結構與範例 | 格式、規則、範例變成可以重用的資產 | 看不見的狀態,每一圈都付前綴,改了就要重量 | 2–4 |
| 三、外部知識 | 它知道你的事,而且引得出出處 | 一份維護合約:五樣東西會鬆掉,鬆掉不報錯 | 5–10 |
| 四、記憶 | 跨輪、跨對話留住狀態 | 越長越貴的重送,和一個要稽核的記憶儲存 | 11–15 |
| 五、工具與技能 | 能動手,能把作法打包 | 工具定義佔掉請求的一大半,資料與指令分不開 | 16–20 |
| 六、代理迴圈 | 自己決定下一步,直到做完 | 圈數、看不見的思考、會走偏,要自己裝煞車 | 21–24 |
| 七、多代理 | 分開的窗口,寫的和審的分開 | 詞元變成倍數,交接會漏資訊,多出新的壞法 | 25–28 |
怎麼知道一層值不值得加,是第 29 篇的題目。
第 24 篇引過 Anthropic〈Building effective agents〉的建議:先找最簡單的解法,需要才加複雜度。把三十篇攤開,上半是七層照順序疊上去、各補第 1 篇的哪個洞,下半是這個系列建議的做法:
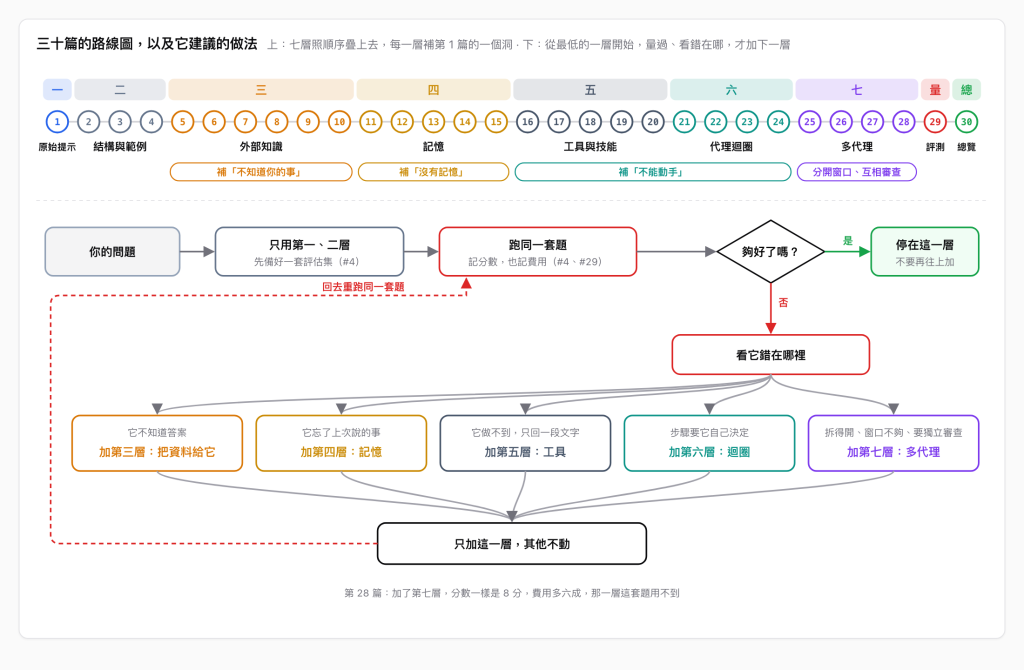
寫成步驟是這樣:
第三步是最容易省略的一步。第 28 篇加了第七層,分數一樣是 8 分,費用多了六成,那一層就是這套題用不到的那一層。
有了評估集和分數,連第二層本身都能交給程式去調。第 2 篇說反覆調提示詞其實是在搜尋,並提到 DSPy 會把這件事自動化:DSPy(Khattab et al., 2023)把一串模型呼叫寫成模組,再由它的編譯器自己產生、挑選範例,把你指定的分數往上推。
第六、七層的八篇是照一條線排的,每一段都是在同一個呼叫外面多包一層:
裡面那個 messages 呼叫,從第 1 篇到這裡沒有變過。
多了什麼能力:看得見七層加上去的東西,最後都落在同一個請求的哪個位置、各佔多少詞元,知道三個洞各補在哪一層、補完還留下什麼,也有一個依錯誤決定加哪一層的流程。
多付了什麼代價:一個 99.9% 不是你寫的請求。你打的那一句之外,每一個詞元都有人替你決定了要放進去,而你要為它付錢、為它負責。
第 1 篇分了兩種進步:「模型變聰明了」,和「工具把更對的東西塞進去了」。這 30 篇講的幾乎都是後者。模型的權重在推論時一個位元都不會動(第 5 篇),我們能動手改的,從頭到尾就是那個請求裡放什麼、外面包幾層。
這個系列裡「它到底送了什麼」的量測,多半是用我自己寫的開源工具 token-inspectour 攔的。如果你也想拿自己的專案量量看,歡迎試試,也很歡迎直接到 GitHub 上開 issue 或送 pull request,一起把它做得更好。
這個系列就寫到這裡。只帶過、沒有展開的,像語音和即時(realtime)代理、微調,之後會再寫成新的文章。


 iThome鐵人賽
 看影片追技術